



 人民網+
 中國共產黨新聞網
 領導留言板
 強國論壇
 人民視頻
具身智能訓練場 機器人“上課”忙
 訂閱已訂閱已收藏
 收藏
 小字號
2026年,具身智能產業站在了一個關鍵節點上。
上半年,我國人形機器人出貨量超過4萬台,全球佔比進一步提升至97%。工業和信息化部預計2026年全年人形機器人產量有望突破10萬台。從制造端看,機器人“造出來”已不是問題,但從“造出來”到“用起來”,中間還有一道尚未完全打通的關口——數據。
訓練機器人,需要大量真實場景中的物理交互數據作為“教材”。據統計,目前,全球可用的高質量真實數據僅為數十萬至百萬小時級,而機器人要迎來“ChatGPT時刻”,需要千萬小時級的真實數據,供需之間存在量級差距。
如何推動人形機器人跨過“數據關”?具身智能訓練場成了關鍵。最初,訓練場因數據需求而建,隨技術演進,訓練場正從單純的數據生產走向場景化的實景實訓,成為真實物理環境中集數據生產、模型訓練與能力驗証於一體的關鍵基礎設施,就像機器人的“學校”。
日前,記者參加“新型工業化調研行”主題採訪活動時來到國內首個基於真實場景的具身智能訓練場——北京人形機器人創新中心具身智能機器人數據與訓練基地(以下簡稱“北京人形數據與訓練基地”),了解機器人如何在這裡“學干活”。
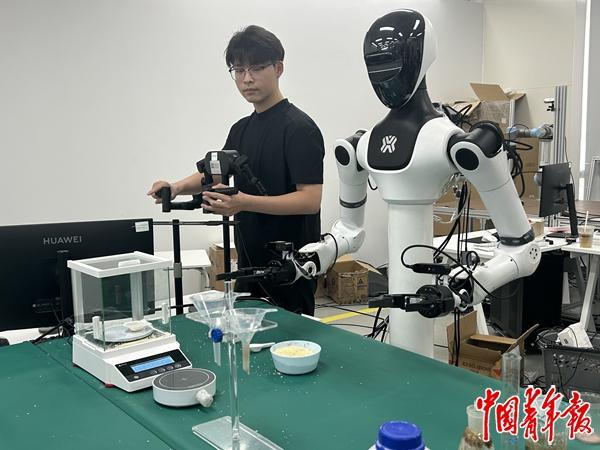
在基地近6000平方米的實訓空間裡,家居、快遞分揀、化學實驗等場景分區鋪開,數十種構型、上百台機器人在不同操作台前反復練習。
化學實驗場景中,一款人形機器人正學習如何夾取托盤,並控制設備,稱量固定克重粉末。這是一個精細化操作的實訓場景,對機器人動作的精度要求很高。機器人身旁的數據採集員穿戴採集設備,小心翼翼地進行夾取物品、稱量粉末等操作,機器人“有樣學樣”,一旁的電腦屏幕上,運動軌跡數據滾動更新,實時回傳到數採系統中。
“這些動作看著很簡單,但要想讓機器人像人一樣熟練,需要大量真實數據訓練模型。”北京人形數據與訓練基地項目經理劉磊介紹,數據採集員的每一次操作,都是在目標物體的形狀、顏色、數量、位置等多種因素隨機組合、動態變化場景中反復採集演示數據。通過學習,機器人不光會模仿,還可以逐步掌握適應不同環境的能力。
截至2026年6月,全國已建成啟用超70家具身智能訓練場,在建、規劃40余家。但具身智能產業發展面臨的“坎”,不光是數據少,還有高質量數據少。
北京人形數據與訓練基地產品負責人史明威坦言,現在市面上很多訓練場對外宣稱“有多少萬小時、億小時的數據”,但實際上可用的是從中抽離出的高質量數據。“對行業來說,1萬小時的高質量數據,可能比100萬小時的重復數據更重要,因為很多數據其實是質量不合格或機器人用不起來的。”
什麼樣的數據才稱得上“高質量”?劉磊以居家整理場景為例說:高質量數據就是機器人到了這個場景后,能自動判定哪些物品需要整理,哪些物品在擺放的過程中易碎需要小心謹慎操作……能精准做出這些指令,才算高質量。反過來,如果在操作過程中對目標判定是模糊、猶豫的,這種情況就是低質量數據。
“‘高質量’的定義,要根據模型的訓練結果去驗証得出來。”劉磊介紹,目前,基地已搭建典型機器人實訓場景30余個。2025年12月,北京人形機器人創新中心面向全球開發者開源開放具身智能數據集RoboMIND,目前全球下載量已突破2000萬次。
為提高數據生產的質量,基地構建了一條完整的數據閉環鏈路。海量數據採集后,會自動上傳至數採系統后台,經過清洗、標注、校驗、質檢等環節,最終留下的有效、高質量數據將被用於算法模型的迭代訓練。這些數據既服務自身機器人研發,也向外部客戶提供。
在上述鏈路中,質檢、標注等環節並非全靠人工。史明威告訴記者,他們會先利用AI進行自動化處理,之后再由人工做少量的質檢和標注。“在採集任務開始之前,我們會對任務做詳細拆解和SOP(標准化流程——記者注)定義,採集員對照定義和文檔判斷動作是否規范,質檢發現問題會反饋給採集員,重新進行採集。”
實際上,閉環的關鍵在於數據加工完成之后。史明威提到,成品數據交付給模型團隊,經測試驗証后進行真機部署,正常來說一個閉環就結束了。“但實際上我們更關注這個模型部署到真機后,在實際作業中遇到哪些問題。我們會通過自動化手段,把問題回流到數採系統中進行分析,並針對性地再次進行數據採集,這就形成了一個大的閉環。”
當前,人形機器人在快遞分揀、工業制造等場景已經有了應用,但不少具身智能訓練場依然保留著上述場景。對此,劉磊以快遞分揀為例解釋說,分揀過程中的關鍵指標是效率和質量,現在快件種類還不夠全面,如有軟包裹、硬包裹、生鮮蔬菜、異常外觀包裹等,需要大規模數據補充。
“地圖類產品每年需要測試員駕車收集城市信息,因為城市會更新變化,機器人模型也要持續補充認知識別能力。”劉磊強調,具身智能賽道所有的數據都需要持續補充,不是說到了某一個節點就足夠用了,“可能機器人這一生都不夠用”。
如果每換一種機器人構型、每換一個場景,就要重新採集一遍數據,生產成本高,具身智能“用起來”的鏈條也難以持續。為此,北京人形數據與訓練基地採用了多種方法,提高數據跨場景、跨本體復用的泛化性。
一方面,在指定場景下不過多限制採集任務和動作﹔另一方面,利用AI做模型泛化。同時,基地也會用頭環等無本體設備讓人來採,還會基於仿真數據進行模型訓練,以保証數據的體量和模型面對不同形態的能力。現實生產生活也是數據的重要來源。史明威說:“靠人力安排任務的方式,只能解決少量問題,要想實現真正的泛化,還得把機器部署到真實場景中去,做整個數據閉環。”
據了解,北京人形數據與訓練基地年數據產能可達18萬小時,已對外交付近3萬小時高質量數據。該基地將上百套無本體採集設備送到家庭、工業等真實環境,讓數據採集從“樣板間”走向真實產線。目前,這個基地正朝著產出百萬小時級“高價值、高可用、可論証”的人形機器人交互數據邁進。
工業和信息化部數據顯示,2025年,我國人工智能核心產業規模超過1.2萬億元,企業超過6200家。中國信息通信研究院近期發布的《具身智能訓練場研究報告(2026年)》指出,近兩年,具身智能訓練場迅速在全國掀起建設熱潮,但場景任務建設同質化、數據實際產能有限、數據多樣性和流通性不足以及可持續商業模式尚未形成等問題逐漸凸顯。
有關部門已關注到數據供給問題。記者從國家發展改革委了解到,下一步,將以具身智能實訓場和應用中試基地為抓手統籌布局具身智能實訓場,加強數據、模型、標准等要素供給。在數據方面,將構建高質量真機數據採集系統,提升具身智能數據供給質量與規模,破解具身智能訓練“數據飢渴”問題。
分享讓更多人看到 
 人民日報
 人民日報少年
 人民網+
 手機人民網
 領導留言板
 人民視頻
 人民智作
人民日報社概況| 關於人民網| 報社招聘| 招聘英才| 廣告服務| 運營服務| 合作加盟| 版權服務| 數據服務| 網站聲明| 網站律師| 信息保護| 聯系我們
人民日報違法和不良信息舉報電話:010-65363263 舉報郵箱:jubao@people.cn
人民網服務郵箱:kf@people.cn 違法和不良信息舉報電話:010-65363636 舉報郵箱:rmwjubao@people.cn
互聯網新聞信息服務許可証10120170001 | 增值電信業務經營許可証B1-20060139 | 廣播電視節目制作經營許可証(廣媒)字第172號 | 京ICP備12004265號-13
信息網絡傳播視聽節目許可証0104065 | 網絡文化經營許可証 京網文[2023]4961-141號 | 網絡出版服務許可証(京)字121號 | 京ICP証000006號 | 京公網安備11000002000008號
人 民 網 股 份 有 限 公 司 版 權 所 有 ,未 經 書 面 授 權 禁 止 使 用
Copyright © 1997-2026 by www.people.com.cn. all rights reserved
-
評論

-
關注
微信微博快手
 第一時間為您推送權威資訊
 報道全球 傳播中國
 關注人民網,傳播正能量
